
ENVIRONNEMENT D'EXÉCUTION D'AGENT
Des modèles de pointe
Nos modèles hébergés sont sélectionnés délibérément, pas pour remplir un menu déroulant. GLM-5.2 pour le développement, MiniMax-M3 pour l'optimisation des coûts, Kimi K2.6 pour la voix IA en temps réel, Qwen3-235B pour des charges de travail équilibrées. Tous exécutés à Paris.
POURQUOI TELNYX
Conçue pour la réglementation européenne
Une infrastructure pensée pour le RGPD et la loi européenne sur l'IA. L'inférence s'exécute en région : vos données restent en France, du stockage au traitement, sans transfert transfrontalier ni zone d'ombre réglementaire. La conformité est intégrée à l'architecture, pas promise dans un contrat.
L'avantage parisien
Exécutez l'inférence au plus près de vos utilisateurs. Le calcul en région garantit une faible latence à travers la France et l'Europe, et vos données sont traitées sur place, jamais routées à l'étranger. Une seule plateforme, un seul réseau, zéro saut entre fournisseurs.
Aucune dépendance fournisseur
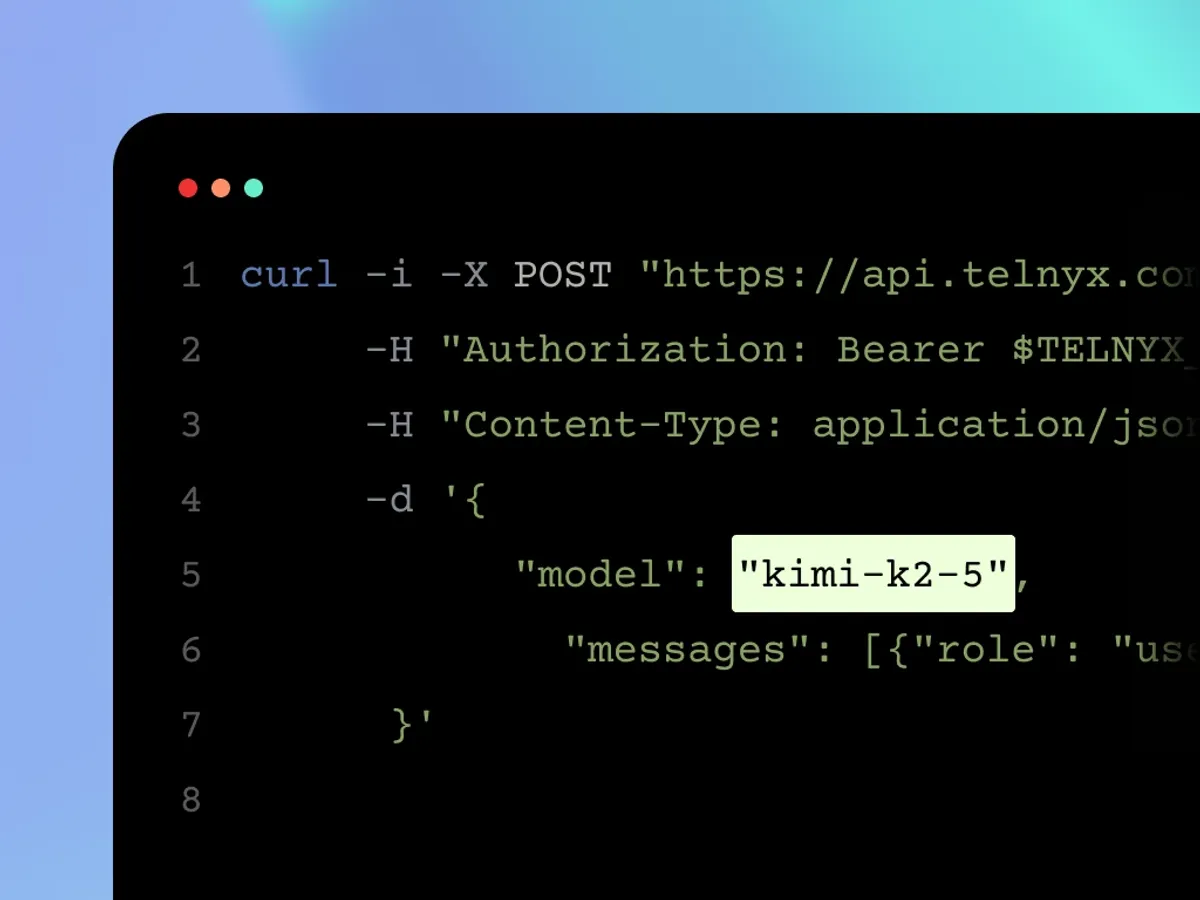
Économisez jusqu'à 75 % par rapport aux modèles propriétaires grâce à des points de terminaison compatibles OpenAI qui fonctionnent avec vos SDK existants, pour changer de modèle facilement sans réécrire de code.
Mise à l'échelle automatique par défaut
Passez de 0 à des milliers de requêtes par seconde sans planifier la capacité disponible. Payez uniquement ce que vous utilisez.
FONCTIONNALITÉS
Une inférence prête pour la production, conçue pour l'Europe
Traité à Paris, pas simplement stocké. L'inférence s'exécute sur une infrastructure physiquement située à Paris, avec une compatibilité OpenAI et aucune réécriture de code.
Traité à Paris, pas seulement stocké
L'inférence s'exécute sur une infrastructure physiquement située à Paris. Vos données restent en France, du stockage au traitement, sans aucun saut transfrontalier.
API compatible OpenAI
Utilisez votre SDK OpenAI existant en changeant simplement l'URL de base. Accédez au calcul parisien et aux modèles open source de pointe en modifiant un seul endpoint.
Function calling
Connectez les LLM à des outils et API externes pour créer des agents qui agissent, et pas seulement génèrent du texte.
Autoscaling
Une capacité dédiée gère les requêtes concurrentes et évolue avec votre charge de travail. Aucune planification de capacité, aucun démarrage à froid.
Fine-tuning
Personnalisez les modèles avec vos propres données via l'API de fine-tuning, sur la même infrastructure en région et avec la même clé API.
Sortie structurée
Le mode JSON et les contraintes regex garantissent que la sortie de l'inférence respecte votre schéma, pour une fiabilité de niveau production.
COMMENT ÇA MARCHE
Migrez en quelques minutes
Compatible OpenAI. Changez votre URL de base, c'est tout.
PRODUITS
Construire une IA qui va au-delà du chat ?
Votre IA n'a pas à s'arrêter au texte. Telnyx exécute la synthèse vocale, la Voice AI et la téléphonie sur la même infrastructure. Même clé API, même réseau, même facture.

Cloud Storage
Découvrez un stockage à faible latence et économique pour vos applications IA. Stockez données et embeddings au même endroit.
En savoir plus
Agents Voice AI
Créez et déployez des agents Voice AI à faible latence en quelques minutes sur une plateforme d'IA conversationnelle complète. Prenez le contrôle des voix, des langues et des flux d'appels.
En savoir plus
Text-to-Speech
Une seule API pour les meilleurs moteurs vocaux. Accédez à ElevenLabs, Rime, MiniMax, Resemble AI et d'autres sans dépendance.
En savoir plus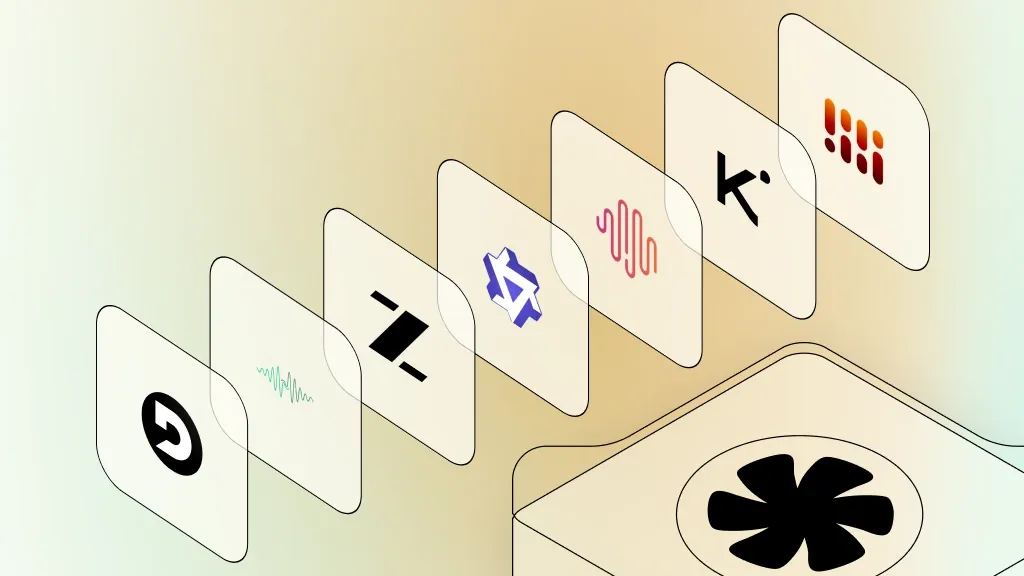
Bibliothèque de modèles
Choisissez parmi une gamme de LLM propriétaires et open-source de pointe et restez à l'avant-garde de l'IA.
En savoir plus