
AGENT RUNTIME
Modelos frontier que se ganan su lugar
Los modelos hospedados se eligen deliberadamente, no para llenar un menú. Kimi K2.6 para voice AI en tiempo real, GLM-5.1 para desarrollo, MiniMax-M3 para costo, Qwen3-235B para cargas de trabajo equilibradas.
POR QUÉ TELNYX
La ventaja del edge
Ejecuta inferencia donde están tus usuarios, con GPUs dedicadas en las Américas, Europa y APAC. El cómputo en región entrega experiencias de baja latencia globalmente, y significa que los datos permanecen donde están tus usuarios, sin problemas de compliance.
Ultra-baja latencia
Ejecuta modelos de última generación en el edge cerca de tus usuarios. Entrega consistentemente tiempos de respuesta sub-100ms en las Américas, UE y APAC.
Sin dependencia de proveedor
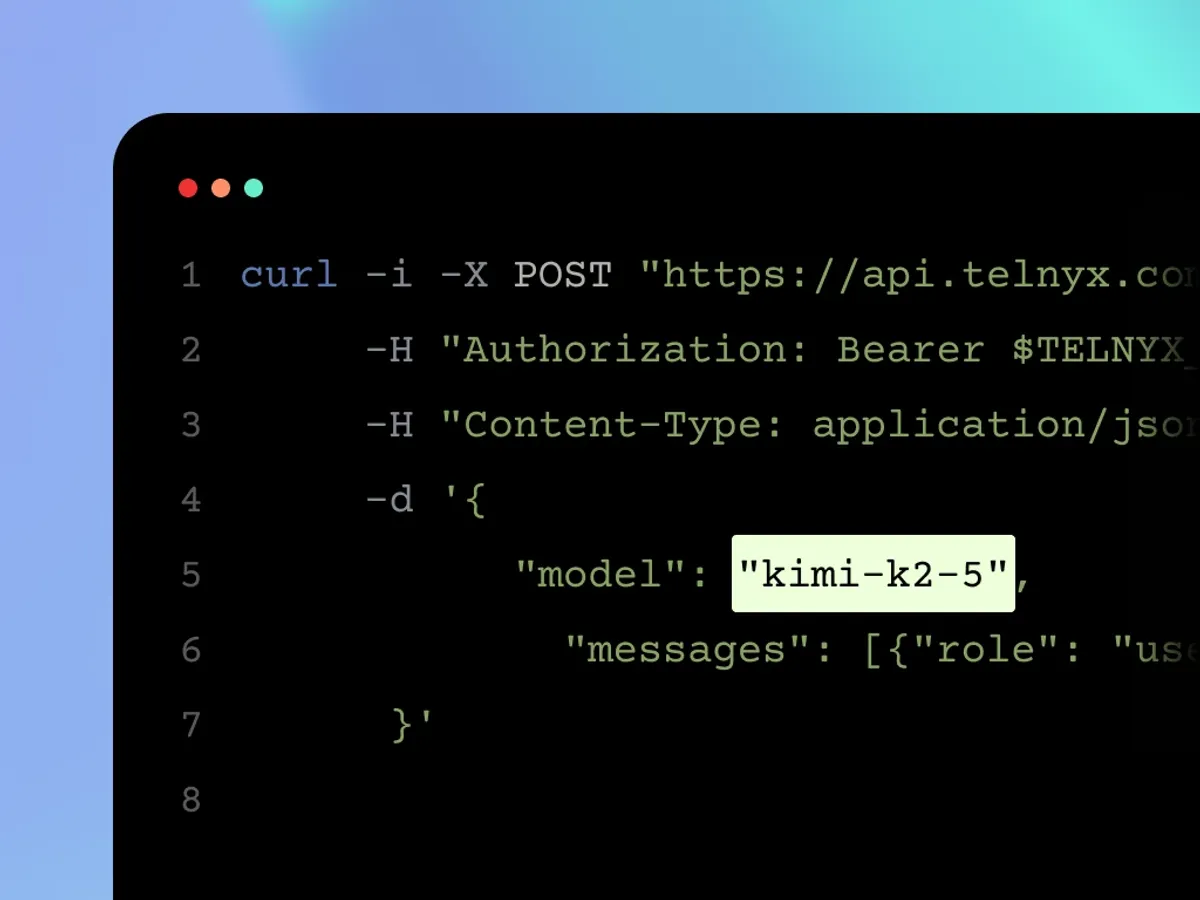
Endpoints compatibles con OpenAI funcionan con SDKs existentes, para que puedas cambiar modelos fácilmente sin reescribir código.
Escalado automático por defecto
Pasa de 0 a miles de requests por segundo sin planificar capacidad disponible. Paga solo por lo que usas.
CARACTERÍSTICAS
APIs de inferencia listas para producción
Endpoints compatibles con OpenAI que funcionan con tu SDK existente y se despliegan globalmente.
Despliegue en región
La inferencia se ejecuta en las Américas, Europa y APAC, con MENA y LATAM próximamente. Tus datos permanecen donde están tus usuarios, y permanecen privados.
API compatible con OpenAI
Usa tu SDK de OpenAI existente cambiando la URL base para acceder a cómputo regional y modelos frontier.
Llamada de funciones
Conecta LLMs a herramientas y APIs externas para construir agentes que toman acción, no solo generan texto.
Escalado automático
GPUs dedicadas manejan requests concurrentes y escalan automáticamente con tu carga de trabajo, sin planificación de capacidad ni cold starts.
Fine-tuning
Personaliza modelos con tus propios datos vía la API de Fine-Tuning usando la misma infraestructura y API key.
Salida estructurada
Modo JSON y restricciones regex aseguran que la salida de inferencia se ajuste a tu esquema para resultados de grado de producción.
HOW IT WORKS
Migra en minutos
OpenAI-compatible. Change your base URL, that's it.
PRODUCTOS
Construyendo IA que va más allá del chat?
Tu IA no tiene que detenerse en texto. Telnyx ejecuta text-to-speech, voice AI y telefonía sobre la misma infraestructura. Misma API key, misma red, misma factura.

Cloud Storage
Descubre almacenamiento de baja latencia y rentable para tus aplicaciones de IA. Almacena datos y embeddings en un solo lugar.
Más información
Agentes de Voice AI
Crea e implementa agentes de Voice AI de baja latencia en minutos en una plataforma conversacional full-stack. Controla voces, idiomas y flujos de llamada.
Más información
Text-to-Speech
Una API para los principales motores de voz. Accede a ElevenLabs, Rime, MiniMax, Resemble AI y otros sin dependencia de un proveedor.
Más información
Biblioteca de modelos
Elige entre una amplia variedad de LLM propietarios y open source de última generación, y mantente a la vanguardia de la IA.
Más información